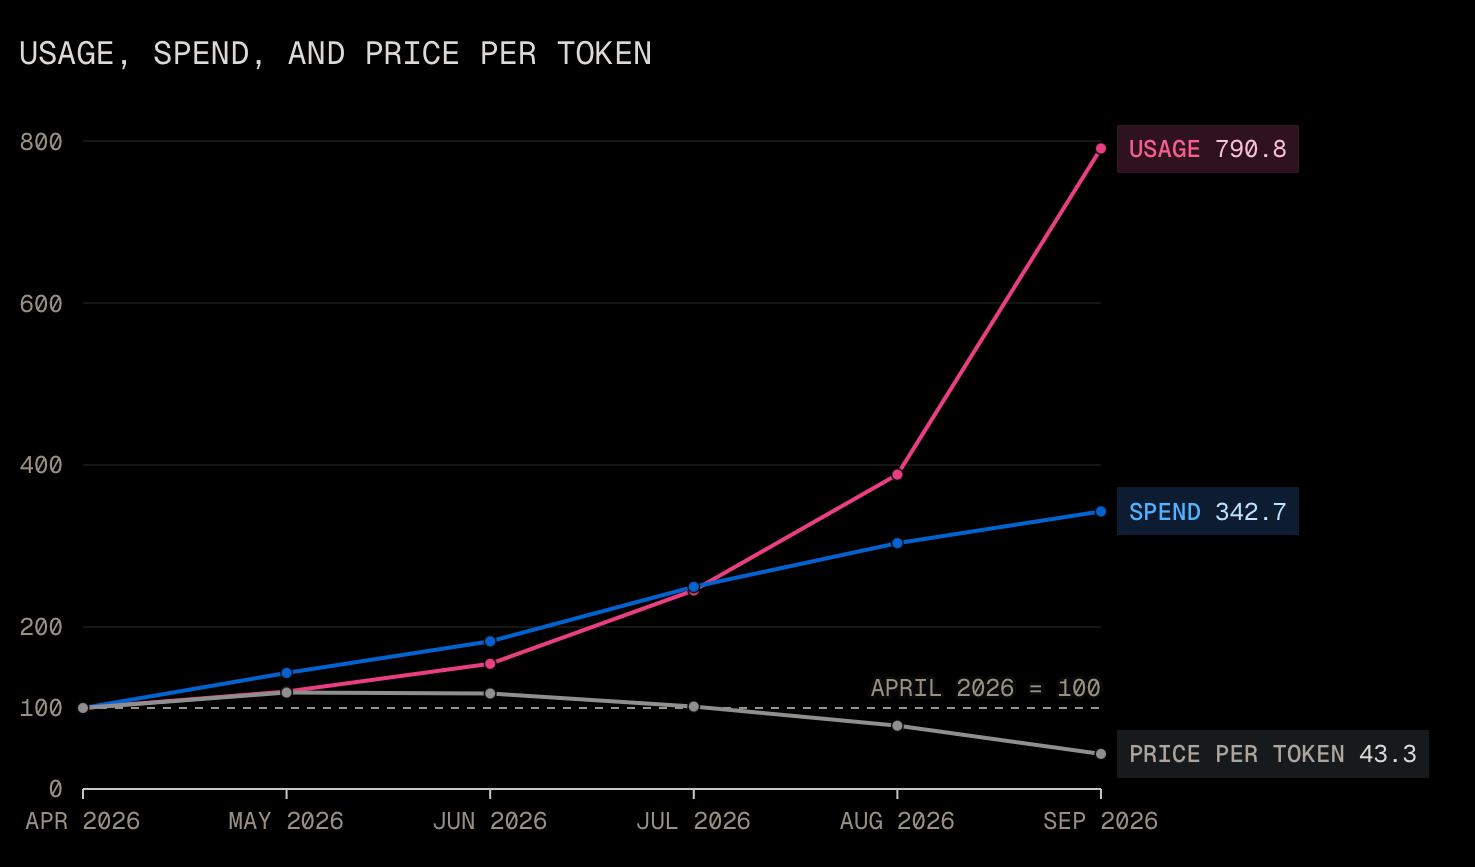
OpenAI e Anthropic reduziram o preço de alguns dos seus modelos de linguagem em até 80% no intervalo de poucos meses. À primeira vista, é ótima notícia para quem usa IA. Mas, olhando de perto, o que está em jogo é uma disputa dura por margem, benchmarks e participação de mercado — e não exatamente generosidade com o cliente.
A análise detalhada dessa movimentação vem do Max Woolf’s Blog, que acompanhou a linha do tempo de lançamentos e cortes das duas empresas.
O contexto: uma enxurrada de lançamentos
Nos últimos meses, as duas companhias despejaram modelos no mercado. A OpenAI lançou o GPT-5.6 nas versões Sol e Luna, além de um Terra intermediário que, segundo o próprio levantamento, quase ninguém notou. A Anthropic respondeu com o Claude Sonnet 5, o aguardado Opus 5 e, mais recentemente, o Fable 5.1.

O ponto importante são os preços, cobrados por milhão de tokens de entrada, saída e leitura de cache. O GPT-5.6 Luna, por exemplo, começou em US$ 1 / US$ 6 / US$ 0,10 e despencou para US$ 0,20 / US$ 1,20 / US$ 0,02 — a tal queda de 80%.
O que mudou de verdade
Aqui entra a parte menos glamourosa. Segundo a análise, se a OpenAI não tivesse feito o corte de 80% no Luna, o modelo perderia na relação qualidade-por-tarefa para o DeepSeek V4 Pro. Ou seja: o preço não caiu porque a tecnologia ficou barata de repente, mas porque a concorrência chinesa pressionou.
A Anthropic seguiu o mesmo roteiro. O preço “temporário” de lançamento do Sonnet 5 virou permanente, um sinal clássico de que a empresa precisou segurar valores para manter clientes.
O caso mais interessante é o do cache. O Fable 5.1 chegou com desempenho melhor que o Fable 5 em todas as áreas e cortou o custo de leitura de cache em 75%. Parece detalhe técnico, mas não é.
Por que isso importa pro seu bolso
Quando se usa IA para programação com agentes, a leitura de cache representa de 96% a 99% de todo o gasto com tokens. Isso acontece porque o cache guarda a conversa inteira, reenviada a cada nova interação. E ele é acionado em quase 100% das vezes.
Na prática, cortar 75% do custo de cache significa reduzir em 70% a 75% o custo real de usar o modelo. Para empresas e desenvolvedores que rodam agentes o dia inteiro, isso muda a conta de forma significativa — bem mais do que os números de entrada e saída que costumam aparecer nas manchetes.
A OpenAI, por outro lado, lançou o GPT-6 Astra com preço parecido ao do Fable 5.1 (US$ 10 / US$ 50 / US$ 1), mas sem o desconto no cache. Desempenho comparável, custo efetivo mais alto para quem usa agentes. É o tipo de diferença que não salta aos olhos numa tabela de preços, mas pesa no fim do mês.
A lição para o usuário é simples: cortes de preço anunciados em porcentagens altas nem sempre refletem o que você realmente vai pagar. O “custo verdadeiro de um token” depende de como você usa o modelo — e as empresas sabem disso ao desenhar suas tabelas. Vale olhar além do número grande na manchete e entender onde o seu gasto de fato acontece.
Fonte: Max Woolf's Blog · Imagem de capa: Max Woolf's Blog
Quer aplicar IA no seu trabalho?
Aprenda qual ferramenta usar para cada tarefa — ChatGPT, Claude, Copilot, Gemini e NotebookLM — nos cursos do IA Todo Dia.
Conhecer os cursos →