Pesquisa
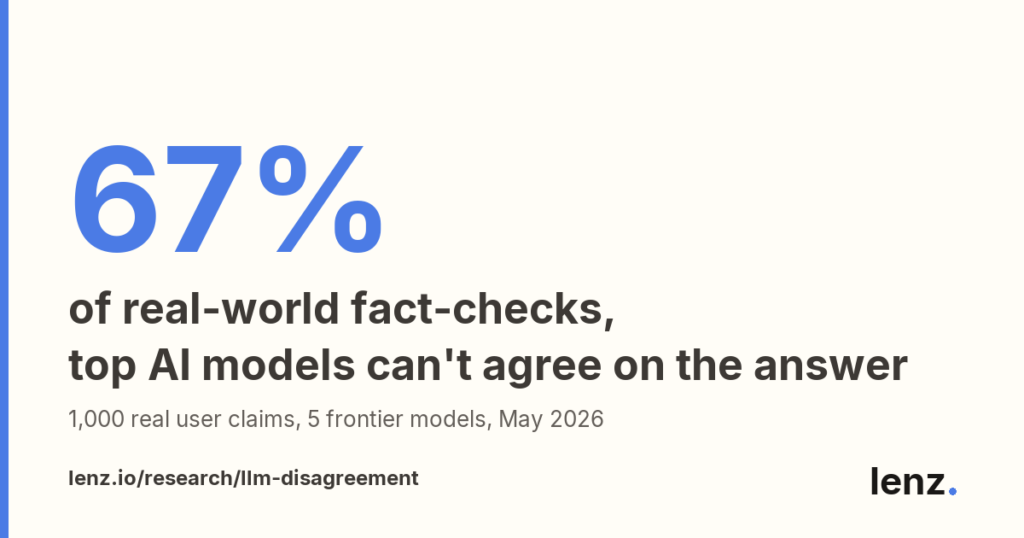
Quando os maiores LLMs discordam: estudo mostra divergência em 67% das checagens
Pesquisa da Lenz testou 1.000 alegações reais em cinco modelos de ponta. Em dois terços dos casos, eles não chegaram ao mesmo veredito.
Pesquisa da Lenz testou 1.000 alegações reais em cinco modelos de ponta. Em dois terços dos casos, eles não chegaram ao mesmo veredito.
Discussão no r/MachineLearning aponta falhas metodológicas sérias no famoso gráfico de “horizontes de tempo” da METR.

No r/MachineLearning, pesquisadores discutem se modelo de raciocínio realmente quebrou limite de Erdős.

Um modelo de raciocínio teria encontrado contraexemplo para uma conjectura clássica da área.

Timothy Gowers afirma ter usado o GPT-5.5 Pro para resolver problemas em aberto e prevê que a pesquisa matemática enfrentará uma crise em breve.

Print viralizado afirma que modelo da OpenAI matou de primeira um problema clássico da matemática combinatória.

Relatório de Stanford aponta que a vantagem americana sumiu e que menos talento estrangeiro quer mudar pros EUA.