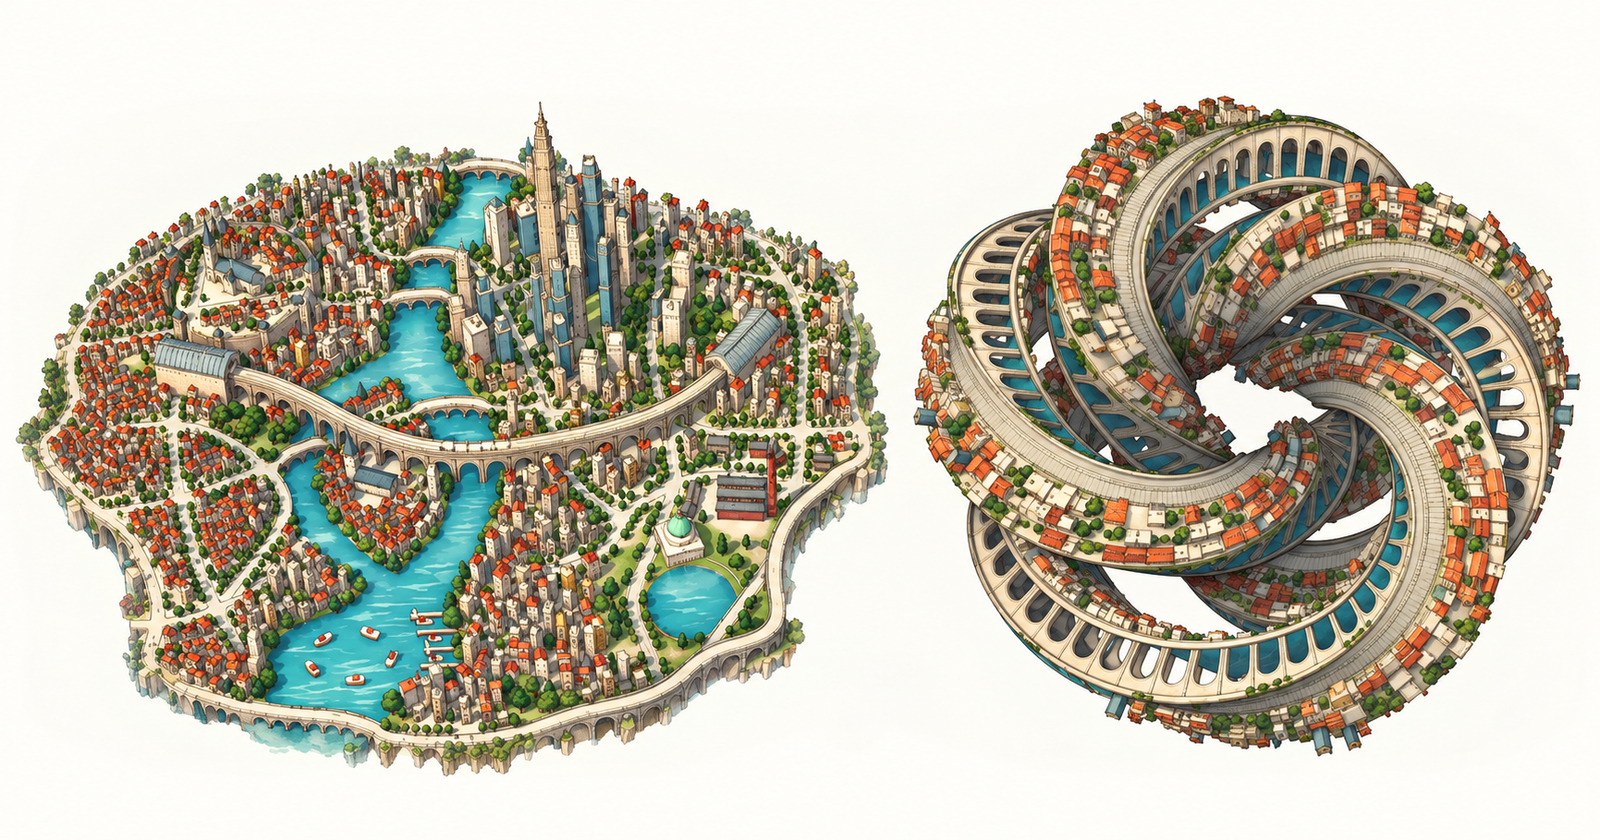
A gente costuma tratar redes neurais como caixas-pretas impenetráveis, mas a Goodfire publicou uma demonstração interativa tentando mostrar o contrário. A ideia é que dá pra olhar dentro dos modelos e organizar o que acontece lá, deixando a estrutura mais limpa e legível.
Isso entra num campo que vem crescendo: a interpretabilidade. Entender por que um modelo toma uma decisão não é frescura acadêmica, é requisito básico pra confiar em sistemas que já tomam decisões sobre crédito, saúde e moderação. O problema é que essas demonstrações muitas vezes impressionam visualmente mas deixam a dúvida: isso escala para modelos de verdade, ou só funciona no exemplo bonitinho?
Vale o clique pela curiosidade, mas com ceticismo. Interpretar redes neurais ainda é mais promessa do que prática consolidada.
Via Hacker News.
Fonte: Goodfire · Imagem de capa: Goodfire
Quer aplicar IA no seu trabalho?
Aprenda qual ferramenta usar para cada tarefa — ChatGPT, Claude, Copilot, Gemini e NotebookLM — nos cursos do IA Todo Dia.
Conhecer os cursos →